

Industry Insights
Agent IA Vocal Microsoft Teams : les 10 KPIs qui comptent en 2026
Les 10 KPIs à mesurer pour un agent IA vocal dans un centre de contact Microsoft Teams en 2026, avec un focus sur le CSAT split bot, hybride, humain.
- agent ia vocal
- voice ai agent
- kpis contact center
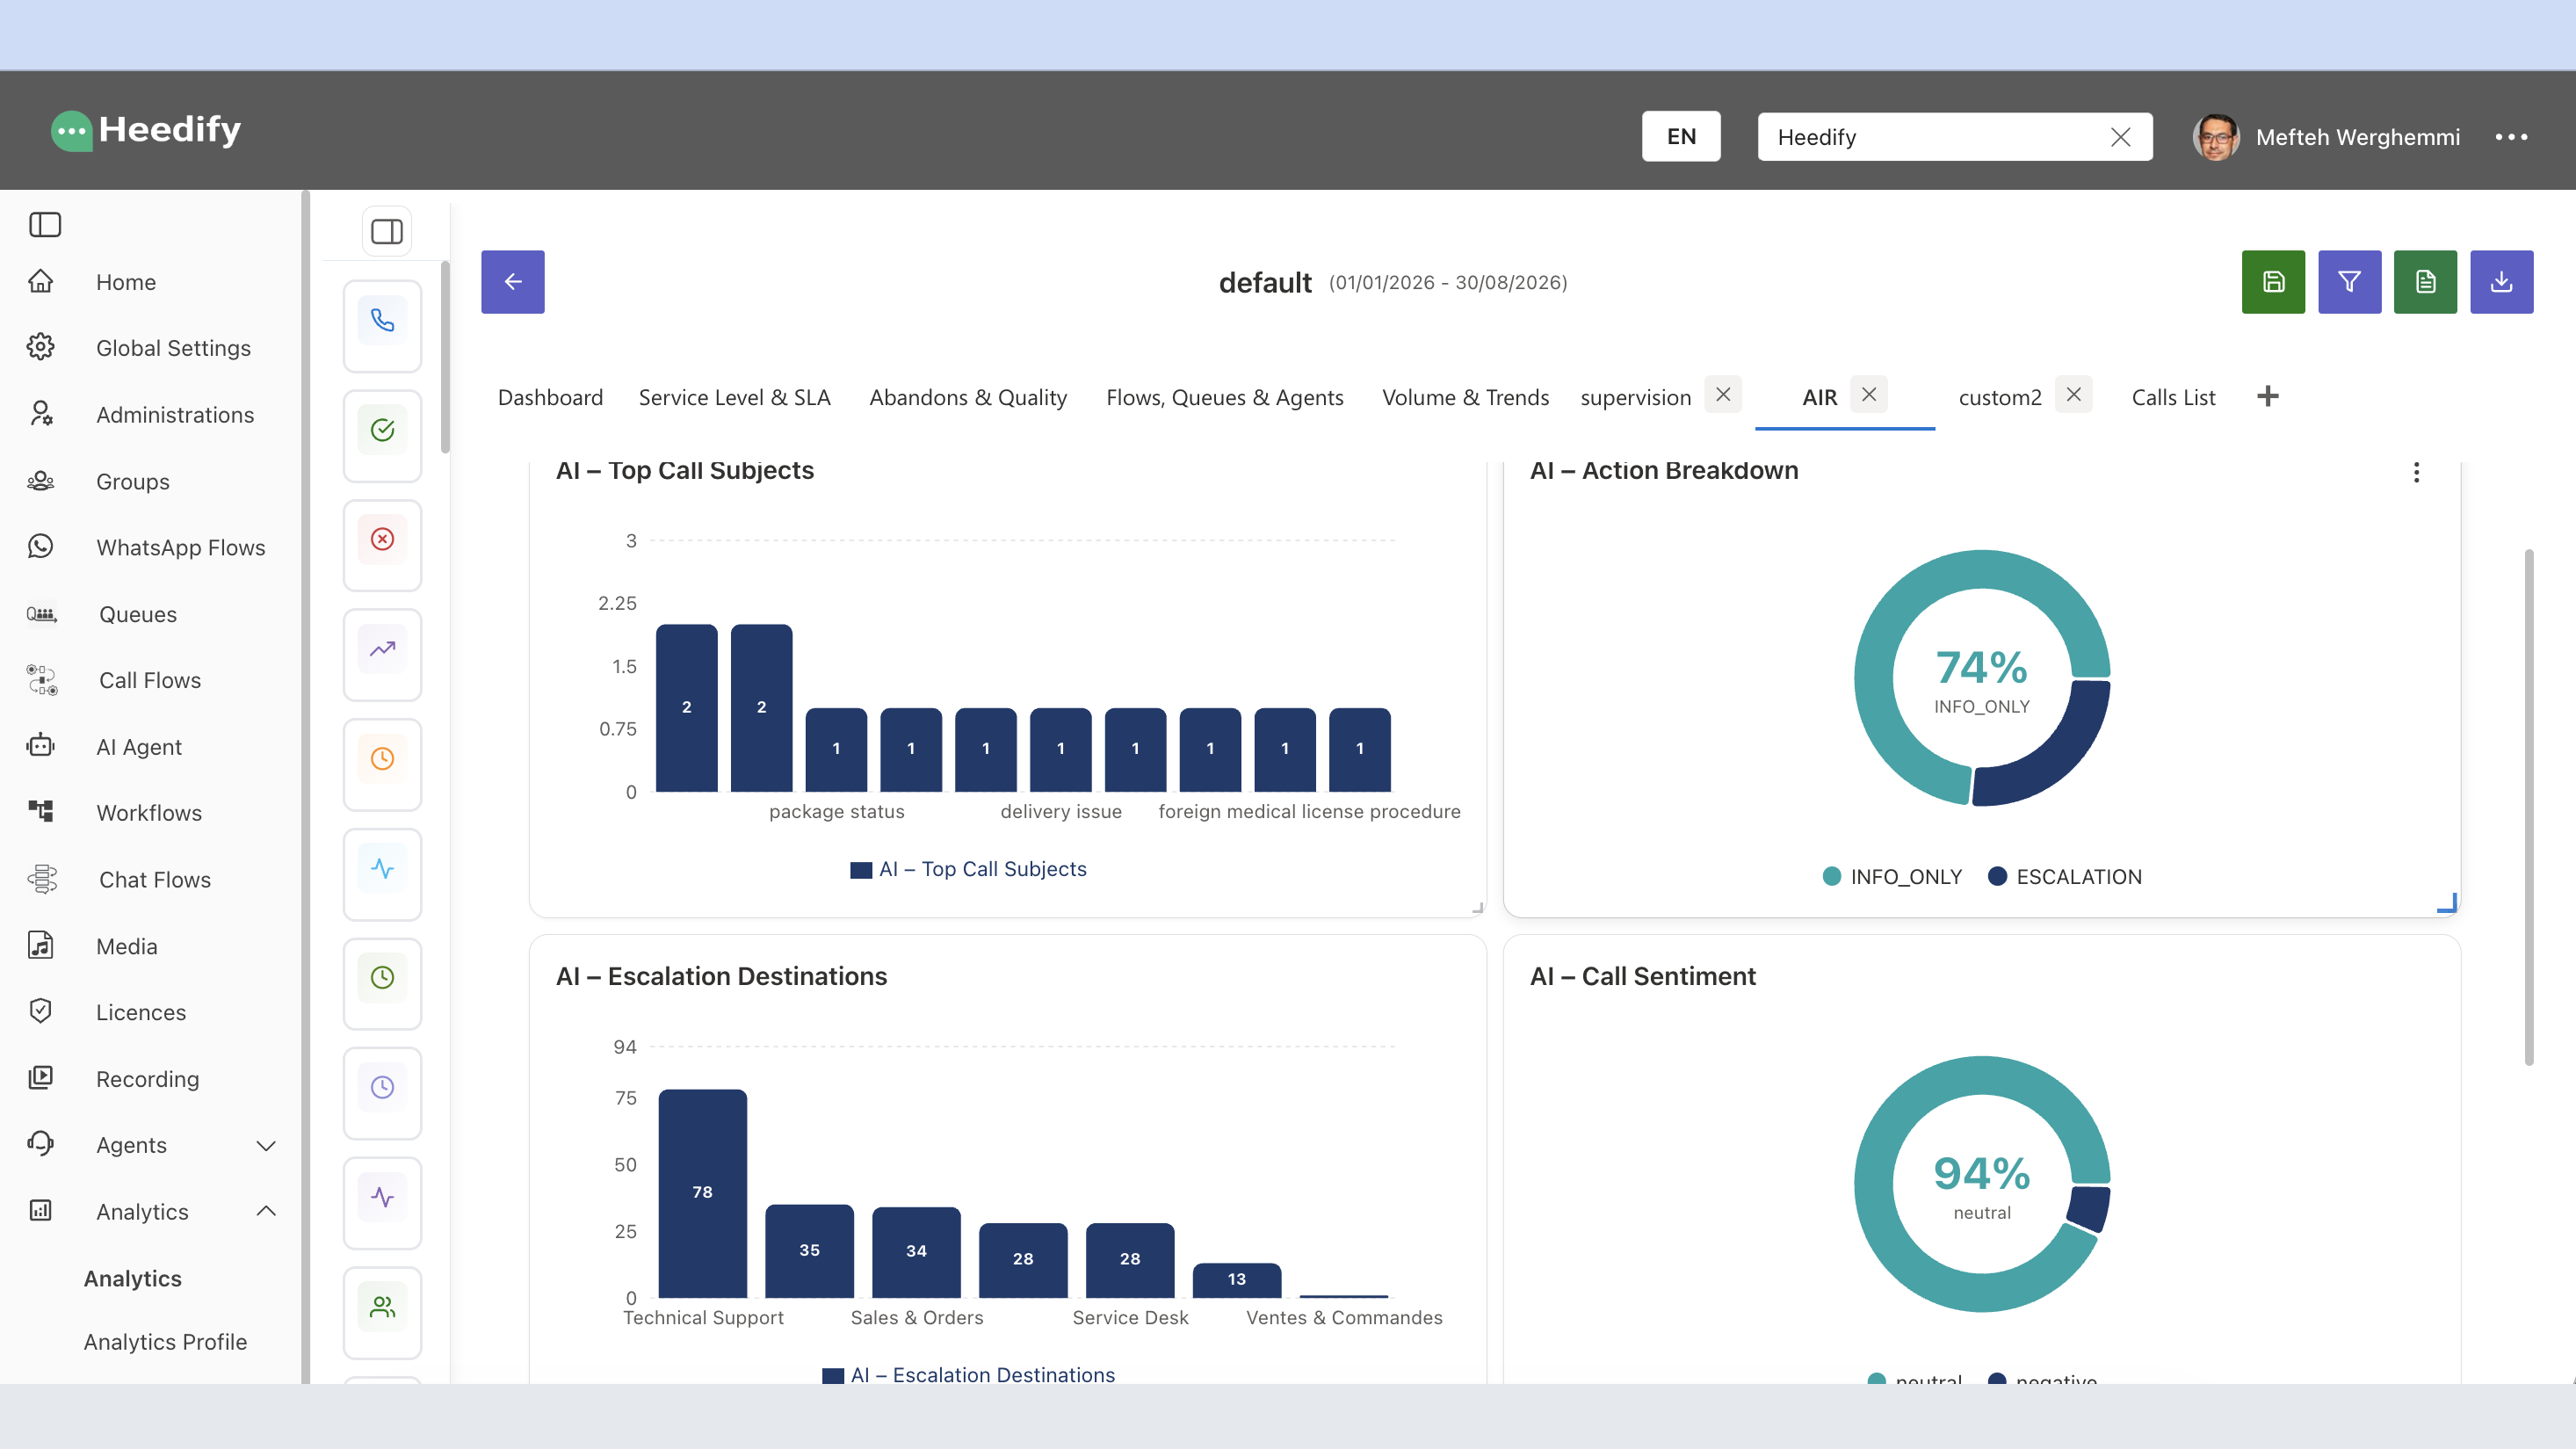
Assez souvent, quand on demande à un manager de centre de contact quel est son outil de reporting préféré, la réponse c’est Excel.
Il télécharge son CSV le lundi matin, applique ses macros, garde ses vues qu’il a construites pendant des années. Ce sont ses données, il en fait ce qu’il veut. Aucun débat à ouvrir là-dessus. Si cet usage ne bouge pas depuis des années, c’est probablement qu’il répond à un vrai besoin quelque part, et chez Heedify nous avons évidemment gardé la possibilité de télécharger les données brutes en CSV ou Excel pour ceux qui préfèrent construire leurs propres vues.
Le vrai débat, il est ailleurs. Il est sur les KPIs qu’on met dans ces fichiers quand on ajoute une couche d’agents IA vocaux. Parce que les métriques héritées de l’ère 100% humaine se transposent mal, et que les nouvelles métriques spécifiques à l’IA n’ont pas encore de standard partagé.
Cet article fait le point sur les 10 KPIs que nous considérons aujourd’hui comme les plus pertinents pour mesurer un agent IA vocal dans un contexte Microsoft Teams, avec un focus particulier sur celui que presque personne ne mesure proprement et qui prouve, ou pas, que votre architecture hybride fonctionne vraiment.
Où on en est vraiment sur les KPIs d’agent IA en 2026
Le sujet est chaud. Il y a une dizaine d’articles de fond qui circulent, chacun proposant sa liste : 5 KPIs, 12 KPIs, 17 KPIs, 32 KPIs. Chaque plateforme voice AI y va de son ranking, généralement biaisé vers ce que la plateforme sait faire.
La vérité, c’est qu’on est tous en phase d’itération. Le secteur n’a pas encore convergé. Les benchmarks de 2024 sont déjà obsolètes, ceux de 2026 se stabiliseront probablement fin 2027. Il n’y a pas de vérité absolue, il y a juste des équipes qui itèrent avec les outils qu’elles ont.
Ce qui a changé cette année, c’est que les managers ne demandent plus “est-ce que l’IA marche ?”. Ils demandent “combien elle nous coûte, combien elle nous rapporte, et est-ce que le client a une meilleure expérience avec elle qu’avec un humain seul ?”. C’est une question à trois dimensions, opérationnelle, économique et expérience. Aucun KPI unique ne répond à ça.
Une note rapide sur la latence perçue avant de plonger dans la liste. Tout le monde en parle, tout le monde vise sous 800 ms pour un ressenti naturel. C’est devenu une commodité. Si votre agent IA est encore au-dessus, vous avez un problème d’infrastructure, pas de mesure. Nous ne le comptons pas dans les 10 KPIs qui suivent.
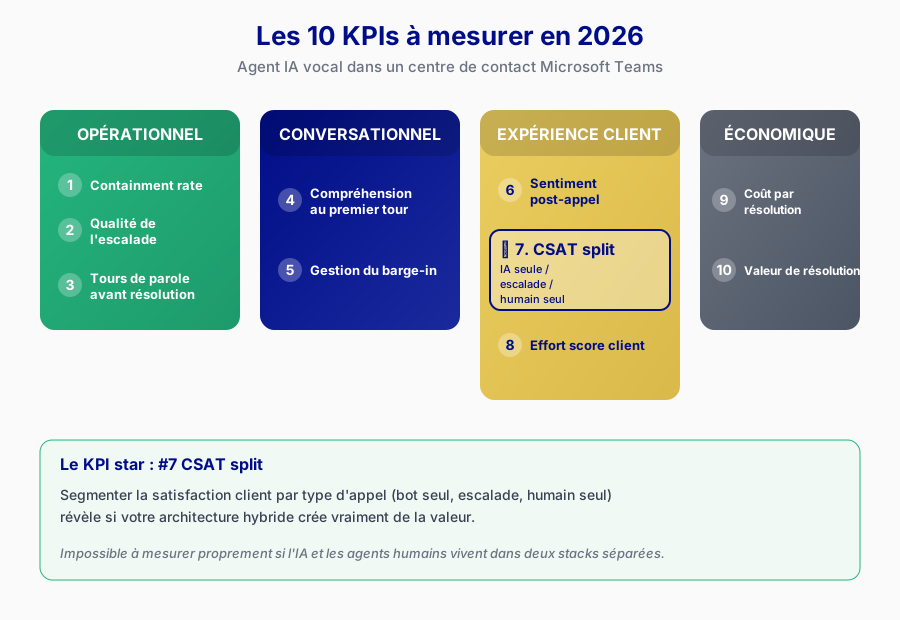
Les 10 KPIs à mesurer aujourd’hui
Structurés en 4 blocs : opérationnel, conversationnel, expérience client, économique.
Bloc opérationnel
1. Containment rate
Le pourcentage d’appels que l’agent IA résout complètement, sans jamais escalader vers un humain. C’est le KPI le plus cité en 2026, et probablement le plus mal utilisé.
Les benchmarks qui circulent (voir notamment les études de Balto et Nextiva) : 20 à 40% pour une implémentation early stage (les 3 premiers mois), 40 à 70% pour un déploiement mature (12 mois et plus). Au-delà de 70%, c’est soit très mature, soit la mesure est fausse (l’IA “termine” un appel où le client a raccroché frustré, ce n’est pas de la containment, c’est de l’abandon).
Piège classique : optimiser aveuglément le containment rate. Si vous forcez l’IA à refuser d’escalader, votre containment monte mais votre CSAT baisse. Ce KPI ne s’interprète jamais seul, il se croise toujours avec la satisfaction client.
2. Qualité de l’escalade vers un humain
Quand l’agent IA transfère à un humain, est-ce que le contexte suit ? L’agent humain reçoit-il un résumé de la conversation, l’intention identifiée, les données déjà collectées, l’état émotionnel du client ?
Ce KPI est encore mal défini dans le secteur. Certains le mesurent en interrogeant l’agent humain post-appel (“avez-vous reçu assez de contexte pour reprendre efficacement ?”), d’autres via des règles automatiques (nombre de champs contexte transmis divisé par nombre attendu).
C’est ce KPI qui différencie une bonne IA d’une IA “patate chaude” qui balance l’appel à un humain sans rien lui expliquer. Le client déteste ça, il doit tout ré-expliquer. C’est là où l’architecture technique compte plus que le modèle de langage.
3. Nombre de tours de parole avant résolution
Combien d’échanges entre l’IA et le client pour arriver à la résolution ? Plus c’est bas, mieux c’est. Un bon agent IA vocal résout une demande simple en 3 à 5 tours de parole. Au-delà de 8, il y a probablement une friction quelque part (mauvaise compréhension, incapacité à agir, boucle).
Ce KPI est un indicateur de qualité conversationnelle plus fin que le containment rate. Deux appels résolus par l’IA peuvent avoir des expériences complètement différentes selon qu’il a fallu 3 ou 12 tours pour arriver au bout.
Bloc conversationnel
4. Taux de compréhension au premier tour
L’IA a-t-elle compris l’intention du client dès sa première phrase ? Ce KPI est un excellent proxy de la qualité du modèle NLU (natural language understanding) et de la préparation des intents. Benchmark 2026 : au-dessus de 85% pour une bonne implémentation.
En dessous de 70%, c’est soit un modèle sous-entraîné, soit des intents mal définis, soit un canal audio dégradé (téléphone bas de gamme, environnement bruyant). Ce KPI aide à diagnostiquer précisément où le problème se situe.
5. Gestion du barge-in
Combien de fois par 100 appels l’IA rate un barge-in (le client parle pendant que l’IA parle, l’IA doit s’arrêter pour écouter) ? C’est le problème classique de VAD (Voice Activity Detection) et d’AEC (Acoustic Echo Cancellation) que tous les builders voice AI rencontrent tôt ou tard.
Un bon système gère le barge-in dans 95%+ des cas. Un mauvais système crée des dialogues absurdes où l’IA continue à parler pendant que le client essaie de s’exprimer, ou pire, prend sa propre voix pour une nouvelle question du client.
Ce KPI est invisible dans la plupart des dashboards. Il faut aller le chercher dans les logs, et souvent réécouter des appels pour le mesurer proprement. C’est un des meilleurs indicateurs de la maturité technique d’une plateforme voice AI.
Bloc expérience client (le cœur du sujet)
6. Analyse de sentiment post-appel
L’analyse de sentiment sur la voix du client tout au long de l’appel : commence-t-il neutre et finit-il satisfait, ou commence-t-il neutre et finit-il en colère ? C’est plus riche que le CSAT survey classique post-appel, parce que ça capture les 95% de clients qui ne répondent jamais aux surveys.
Attention au biais : l’analyse de sentiment en français ou en anglais est mature, mais certaines langues (arabe, hindi, portugais européen) donnent des résultats moins fiables. À croiser toujours avec un échantillonnage humain pour calibrer.
7. CSAT split : bot-only, escalated, human-only ⭐
C’est le KPI qui ferait toute la différence dans une décision d’achat de plateforme voice AI, et pratiquement personne ne le mesure proprement.
Il consiste à segmenter les CSAT en trois catégories selon le type d’appel :
- Bot-only : appels traités entièrement par l’IA, jamais escaladés
- Escalated : appels démarrés par l’IA, transférés à un humain en cours de conversation
- Human-only : appels routés directement à un humain sans passer par l’IA
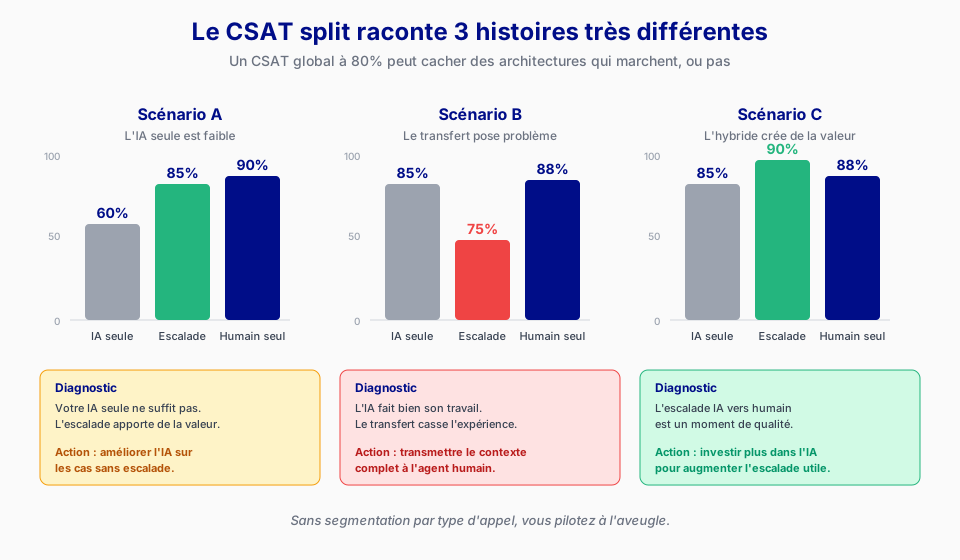
Un CSAT global de 80% ne dit rien. Il peut cacher :
Scénario A : bot-only à 60%, human-only à 90%, escalated à 85%. Conclusion : votre IA ne suffit pas seule, mais quand elle escalade elle apporte de la valeur. Action : améliorer l’IA sur les cas bot-only ou réviser sa politique de containment.
Scénario B : bot-only à 85%, escalated à 75%, human-only à 88%. Conclusion : votre problème est dans le hand-off, pas dans l’IA. L’IA fait bien son travail, mais quand elle transfère, le client sent une cassure. Action : améliorer la transmission de contexte à l’humain.
Scénario C : bot-only à 85%, escalated à 90%, human-only à 88%. Conclusion : votre hybride ajoute vraiment de la valeur. L’escalade est un moment de qualité, pas de friction. Action : investir plus dans l’IA pour augmenter le taux d’escalade utile.
Sans ce split, vous prenez des décisions à l’aveugle sur votre stratégie voice AI.
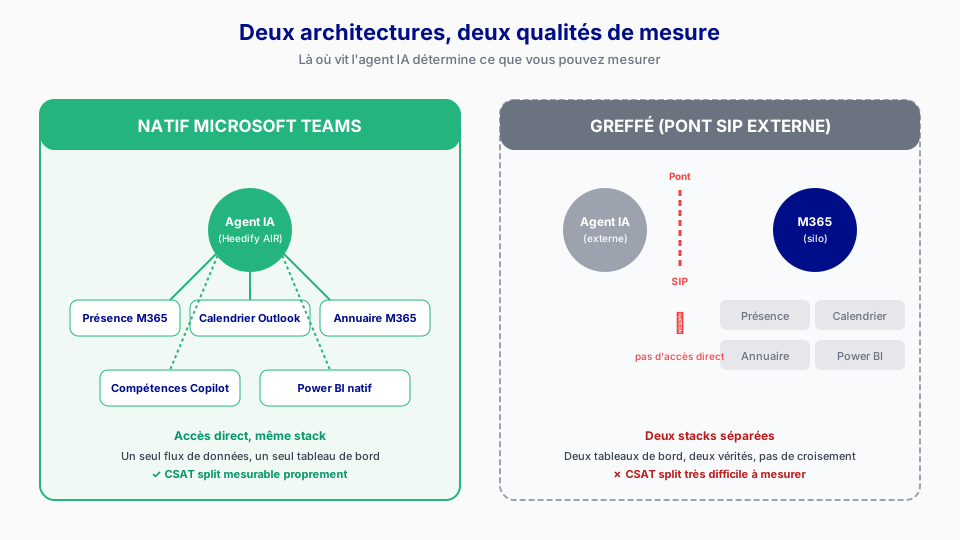
Le vrai obstacle à mesurer ce KPI, ce n’est pas la difficulté conceptuelle. C’est que la plupart des plateformes voice AI vivent dans une stack séparée du contact center humain. L’IA a son dashboard, les agents humains ont le leur, les CSAT sont collectés dans deux systèmes différents qui ne se parlent pas. Résultat, la segmentation propre est impossible.
Quand votre agent IA vit nativement dans la même stack que vos agents humains (ce qui est le cas dans Microsoft Teams natif, où l’IA est un participant Teams comme un humain), vous pouvez collecter ces trois CSAT sur le même canal, avec les mêmes règles, et faire le split proprement. C’est un des vrais avantages architecturaux d’une plateforme native Teams par rapport à une plateforme voice AI branchée en SIP externe.
À garder en tête
Si vos CSAT bot-only et escalated sont trop proches, votre escalade sert à rien et vous payez deux fois. Si escalated est bien au-dessus des deux autres, vous prouvez la valeur du hybride, et vous pouvez justifier l’investissement continu dans l’IA.
8. Effort score client
Combien d’énergie le client a-t-il dû dépenser pour être servi ? Un client qui obtient sa réponse en 2 minutes sans avoir à répéter ni naviguer dans un menu vocal, c’est un effort score bas. Un client qui doit épeler son nom trois fois, se faire couper la parole, reformuler sa question, c’est un effort score haut.
C’est un des meilleurs prédicteurs de la fidélité client sur le long terme. Plus l’effort est bas, plus le client reviendra.
Concrètement, il se calcule en pondérant plusieurs signaux détectables automatiquement sur l’appel :
| Signal | Comment on le mesure | Pondération suggérée |
|---|---|---|
| Nombre de reformulations du client | Détecté par similarité sémantique entre 2 tours de parole consécutifs | 25% |
| Sollicitations d’explication supplémentaire côté IA | Analysé par une IA qui identifie les phrases de type “pouvez-vous préciser”, “je n’ai pas compris”, “reformulez s’il vous plaît” | 20% |
| Silences longs (>3 sec) | Log des timestamps audio, filtrés par durée | 15% |
| Nombre d’escalades demandées par le client | Détecté par intent “parler à un humain” | 20% |
| Réponse mini-survey post-appel (“Was it easy ?” 1 à 5) | Automatisé via SMS, message Teams ou WhatsApp après l’appel | 20% |
Formule simple : on normalise chaque signal sur une échelle 0-100 (0 = zéro effort, 100 = effort maximum), on applique les pondérations, on obtient un score global par appel. Un effort score moyen inférieur à 30 est bon, entre 30 et 50 est moyen, au-dessus de 50 il faut agir.
Le mini-survey post-appel est le seul signal manuel, mais avec un taux de réponse de 10 à 15% sur un centre de contact bien piloté, il suffit à calibrer les signaux automatiques du reste.
Bloc économique
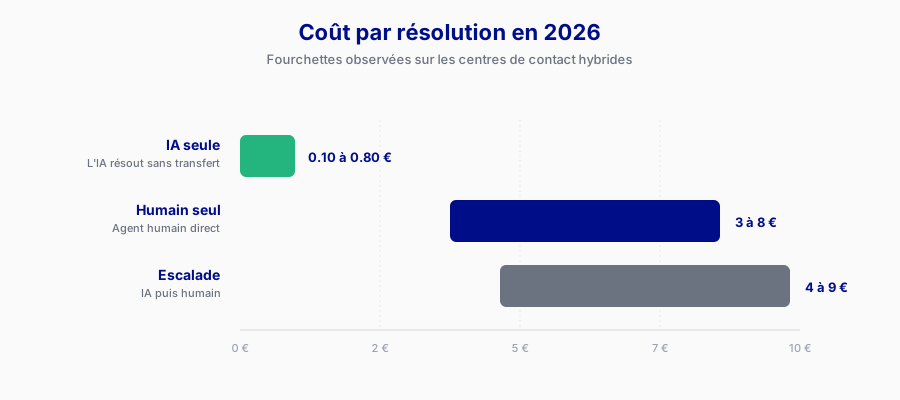
9. Cost per resolution : IA vs humain vs hybride
Ce n’est pas juste “l’IA coûte moins cher que l’humain”. C’est plus nuancé :
- Coût par résolution bot-only (généralement le plus bas, entre 0.10 et 0.80 euro selon le volume)
- Coût par résolution human-only (généralement 3 à 8 euros selon la géographie et le niveau de compétence)
- Coût par résolution escalated (la somme des deux, souvent 4 à 9 euros)
Le vrai calcul, c’est de comparer le coût par résolution moyen dans un mix hybride (qui inclut les trois types) avec ce que coûterait le même volume traité 100% par humain. C’est là que vous voyez si votre IA est un investissement rentable, ou juste un gadget qui vous fait perdre du CSAT sans économiser vraiment.
10. Resolution value
Toutes les résolutions ne se valent pas. Un appel client de 45 minutes qui sauve un compte à 50 000 euros vaut infiniment plus qu’un appel de 3 minutes qui accélère la perte d’un compte à 800 euros.
Ce KPI, c’est le rappel que la vitesse n’est pas toujours l’objectif. Certains segments de clients méritent des appels longs et des escalades généreuses. D’autres segments peuvent être traités très rapidement par l’IA sans risque. La segmentation par valeur client, croisée avec le comportement IA/humain, c’est là où les managers matures pilotent leur centre de contact en 2026.
Le vrai game-changer : mixer humain et IA dans un seul dashboard
C’est là où la plupart des outils échouent, et où la conversation devient intéressante pour les managers.
Les agents humains et les agents IA sont deux mondes séparés dans le reporting classique. Le manager du contact center voit son dashboard humain (agents connectés, temps de traitement moyen, taux de résolution). Le manager IT ou digital voit son dashboard IA (containment rate, coût par appel, sentiment). Personne ne voit les deux ensemble.
Sauf que dans un contact center moderne, les deux ne sont pas séparables. Un client peut commencer par l’IA, être escaladé, revenir 3 jours plus tard pour un follow-up avec un humain, être re-routé vers l’IA pour un rappel automatique. Le parcours est unifié, la mesure doit l’être aussi.
Ce que vous voulez dans votre dashboard :
- File d’attente unifiée : combien de clients attendent, peu importe s’ils vont être servis par IA ou humain
- Escalation flow visualisé : où les clients transitent, à quel moment, avec quelle satisfaction
- Cost per resolution comparatif : IA seule, humain seul, hybride
- SLA tenu par le mix, pas par les composants séparément
C’est ce type de dashboard unifié que nous construisons chez Heedify avec Heedify Analytics. Le fait que l’IA (Heedify AIR) et les agents humains vivent dans la même stack Microsoft Teams permet d’avoir un seul flux de données, une seule vérité, un seul dashboard. Filtres, couleurs, croisement métriques agent + file + IA, tout est là et tout est personnalisable.
Pourquoi le contexte Microsoft Teams change la donne
La plupart des articles qui parlent de KPIs voice AI raisonnent en abstrait, comme si l’IA vivait dans un cloud et le contact center dans un autre. C’est vrai pour beaucoup de plateformes. Ce n’est pas vrai pour les contact centers natifs Microsoft Teams.
Dans un contact center natif Teams, votre agent IA a accès nativement à :
- La présence Microsoft 365 (l’IA sait qui est disponible, qui est en réunion, qui est absent)
- Le calendrier Outlook (pour prendre des rendez-vous ou vérifier des disponibilités)
- L’annuaire d’entreprise (pour transférer vers la bonne personne, pas juste un numéro)
- Les compétences Copilot (pour enrichir les réponses avec des données M365)
- Power BI natif (pour reporter directement sans exporter)
Ça change les KPIs que vous pouvez mesurer, et ça change surtout la qualité de mesure. Le containment rate d’une IA qui a accès au calendrier des personnes escaladables, c’est mécaniquement plus élevé qu’une IA qui doit deviner qui est dispo. La qualité de l’escalade d’une IA qui transfère avec le contexte complet dans le chat Teams de l’agent, c’est mécaniquement plus haute.
C’est un point que peu d’articles couvrent, parce qu’ils raisonnent sur des plateformes voice AI génériques. Si vous êtes dans un environnement Microsoft Teams, vous devez demander à votre fournisseur voice AI comment il exploite cette intégration, pas juste quels modèles LLM il utilise.
Nous sommes en phase d’itération, personne n’a la vérité
Il faut le dire clairement : personne n’a la formule magique. Les benchmarks changent tous les six mois. Les KPIs qu’on considère centraux aujourd’hui seront peut-être secondaires dans 18 mois, remplacés par d’autres qu’on n’a pas encore identifiés.
Ce qui compte à ce stade, c’est de choisir une plateforme qui vous laisse itérer. Une plateforme où vous pouvez ajouter un KPI custom sans changer d’outil, où vous pouvez redéfinir un seuil sans mettre en pause votre opération, où vous pouvez croiser deux métriques sans dépendre d’une équipe data.
Le manager qui pilote un centre de contact hybride en 2026 n’a pas besoin d’un tableau de bord parfait. Il a besoin d’un tableau de bord qu’il peut modifier vite quand la réalité change.
Comment Heedify approche ce sujet
Chez Heedify, nous avons construit Heedify Analytics avec cette philosophie : 100% personnalisable, dans Teams, avec accès natif aux données M365. Chaque manager configure ses filtres, ses couleurs, ses croisements. Le CSAT split bot-only / escalated / human-only est disponible par défaut parce que nous considérons que c’est le KPI le plus important pour un contact center hybride en 2026.
Si vous êtes en train de définir vos KPIs voice AI, ou si vous êtes frustré parce que votre plateforme actuelle ne vous permet pas de faire le split proprement, nous sommes ouverts à en discuter avec vous. Nous construisons ce sujet avec nos clients pilotes, il y a beaucoup à apprendre ensemble.
Résumé
Les 10 KPIs à mesurer aujourd’hui pour un agent IA vocal dans un contact center Microsoft Teams :
Opérationnel : containment rate, qualité de l’escalade vers un humain, nombre de tours de parole avant résolution.
Conversationnel : taux de compréhension au premier tour, gestion du barge-in.
Expérience client : analyse de sentiment post-appel, CSAT split bot / escalated / human-only, effort score client.
Économique : cost per resolution IA vs humain vs hybride, resolution value.
Le KPI à surveiller en priorité en 2026, c’est le CSAT split. C’est celui qui vous dit vraiment si votre hybride marche, et c’est celui que presque personne ne mesure proprement parce qu’il exige une stack unifiée entre IA et agents humains.
Un contact center natif Microsoft Teams, avec son agent IA et ses agents humains dans la même couche, permet ce niveau de mesure. C’est un des vrais avantages architecturaux à considérer quand vous comparez les plateformes voice AI en 2026.
Questions fréquentes sur les KPIs d’agent IA vocal
Quel est le KPI le plus important pour un agent IA vocal en 2026 ?
Le CSAT split par type d’appel (bot-only, escalated, human-only) est le KPI qui a le plus d’impact décisionnel en 2026. Il révèle si votre architecture hybride crée vraiment de la valeur, ou si vous payez pour une escalade qui n’améliore rien. Le containment rate reste le KPI le plus cité, mais il ne suffit pas seul.
C’est quoi un bon containment rate pour un agent IA vocal ?
Entre 20 et 40% pour une implémentation early stage (3 premiers mois), entre 40 et 70% pour un déploiement mature (12 mois et plus). Au-delà de 70%, vérifiez que vos “résolutions” ne cachent pas des abandons ou des clients frustrés qui ont raccroché.
Est-ce que les KPIs humains classiques (AHT, CSAT, FCR) s’appliquent à un agent IA ?
Partiellement. L’AHT (Average Handle Time) devient presque insignifiant pour une IA qui coûte quelques centimes par appel. Le CSAT classique reste utile mais souffre de biais de nouveauté. Le FCR (First Call Resolution) demande une redéfinition dans un contexte hybride. Il est plus efficace d’ajouter des KPIs spécifiques (containment rate, escalation quality, first-turn understanding) plutôt que de forcer les KPIs humains sur l’IA.
Comment mesurer la qualité de l’escalade IA vers humain ?
Deux approches complémentaires. Approche automatique : compter le nombre de champs de contexte transmis à l’agent humain (transcription, intention identifiée, données collectées, sentiment) divisé par le nombre attendu. Approche déclarative : mini-survey de l’agent humain post-appel (“avez-vous reçu assez de contexte pour reprendre ?”). Croiser les deux donne une image fiable.
Pourquoi le contexte Microsoft Teams change-t-il la mesure des KPIs ?
Parce que l’agent IA a accès nativement aux données M365 (présence, calendrier, annuaire, Copilot, Power BI). Cela augmente mécaniquement la qualité des KPIs (meilleure escalade, meilleur containment) et permet le CSAT split parce que l’IA et les agents humains vivent dans la même stack. Une plateforme voice AI branchée en pont SIP externe ne peut pas offrir ce niveau de mesure.
Comment Heedify approche les KPIs voice AI ?
Heedify Analytics est un moteur de tableaux de bord 100% personnalisable, natif Microsoft Teams. Chaque manager configure ses filtres, ses couleurs, ses croisements de métriques. Le CSAT split bot-only / escalated / human-only est disponible par défaut, ainsi que les 10 KPIs présentés dans cet article. La visualisation croisée agent humain + agent IA dans un seul tableau de bord est l’un des différenciateurs principaux.
Sources et références
Cet article s’appuie sur les analyses de fond publiées en 2026 par :
- Balto — KPIs for Voice AI Agents in Contact Centers (17 métriques)
- Nextiva — AI Agent Performance Metrics for 2026
- Famulor — 12 Voice AI Agent KPIs That Matter in 2026
- Retell AI — 32 Call Center Metrics That Actually Predict Performance
- Rasa — 5 Contact Center KPIs You Must Track
- Ada — Top metrics for AI voice agents in customer service
- Documentation Microsoft : présence Teams, Copilot